BABA RT — 수술 영상 57건에서 검토할 것만 골라내는 에이전트 파이프라인
갑상선 로봇수술 영상을 10개 에이전트가 크로스체크해 검토 우선순위 큐로 정렬한다. 모든 판단에 근거를 달고, 미검증 가설은 미검증이라고 화면에 쓴다.
- 날짜
- 역할
- 기획 · 구현
- 기술
- Claude Code · Python · YAML 룰 · HTML 리포트
왜 만들었나
BABA 로봇 갑상선 수술 한 건의 영상은 두 시간에 가깝다. 수술을 마친 외과의가 “통상에서 벗어난 순간이 있었나”를 확인하려면 그 두 시간을 다시 봐야 한다 — 그래서 아무도 다시 보지 않는다.
상대가 숙련의라는 점이 문제를 더 어렵게 만든다. 기본 임상 룰은 이미 알고 있으니 “이 약은 안 됩니다” 같은 알림은 가치가 없다. 정작 확인하고 싶은 것 — 본인도 인지하지 못한 채 굳어진 습관 — 은 어떤 도구도 짚어주지 않는다.
무엇을 만들었나
케이스 57건의 수술 영상 데이터를 분석해, 검토할 가치가 있는 케이스만 우선순위 큐로 올리는 시스템이다. 회사 프로젝트로, 기획부터 구현까지 직접 진행하고 있다.
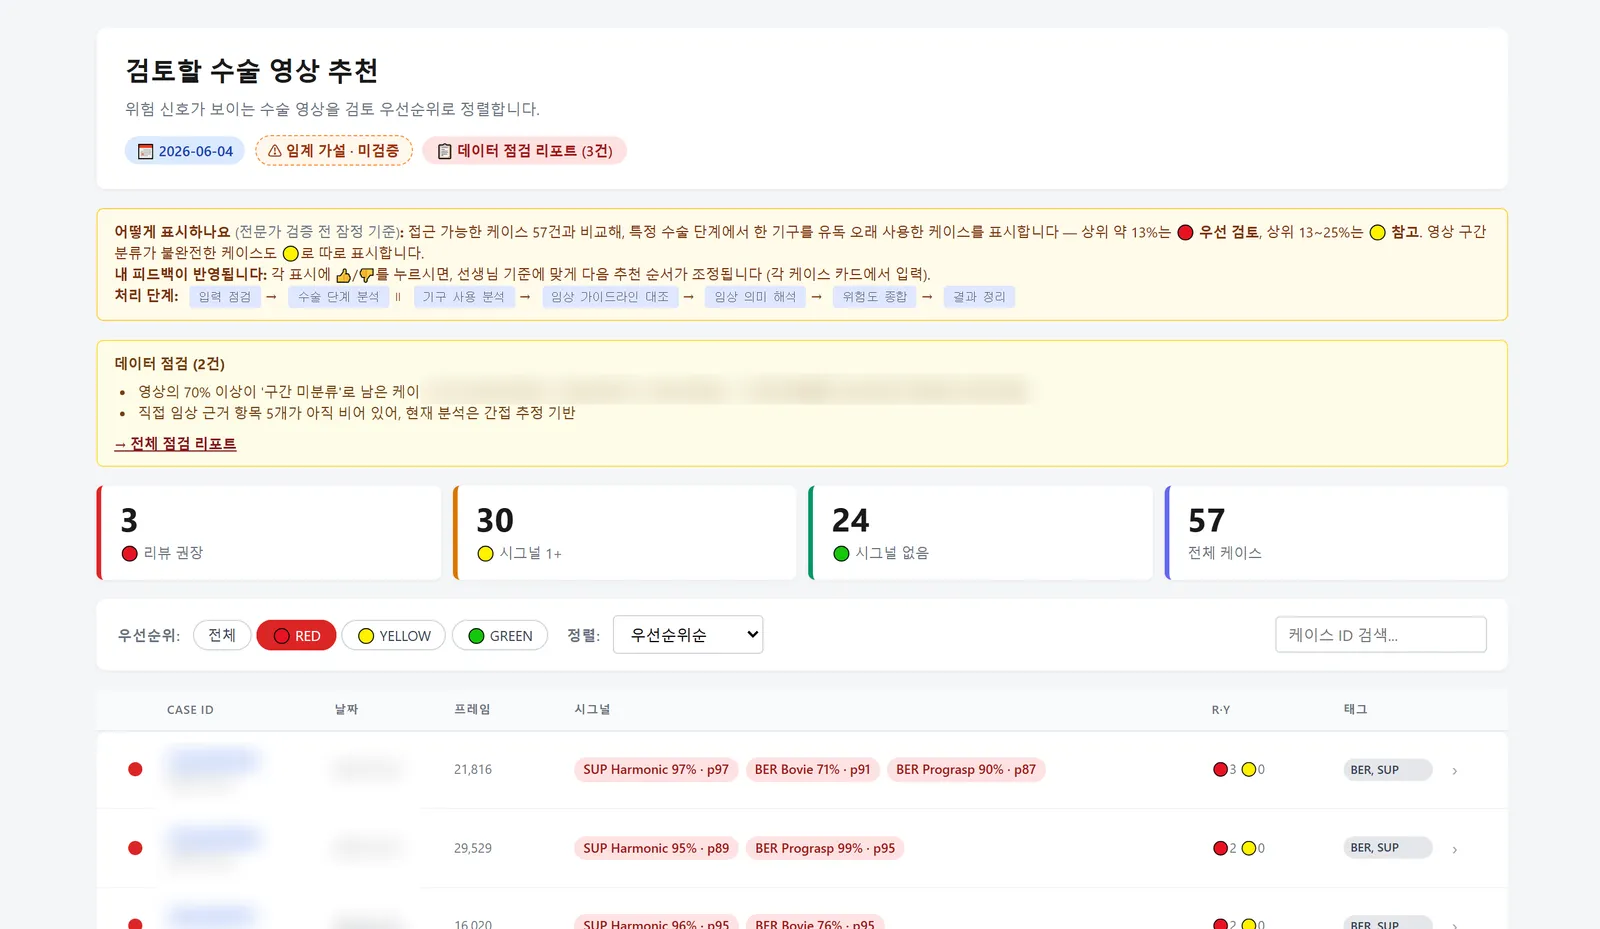
대시보드. 동료 57건과 비교해 특정 수술 단계에서 한 기구를 유독 오래 쓴 케이스를 신호등으로 나눈다 — 이날은 리뷰 권장 3건, 시그널 1개 이상 30건, 시그널 없음 24건. 상단에 “임계 가설 · 미검증” 배지가 붙어 있는 것도 의도한 부분이다.
화면의 케이스 식별자와 수술 날짜는 블러 처리했다. 화면 구성을 보여주는 것이 목적이므로 환자·케이스를 특정할 수 있는 정보는 남기지 않았다.
시그널 하나를 열면 “왜 RED인가”를 5단계로 펼쳐 보인다. 수술 단계 → 도구 사용 → 임상 가이드라인 → 임상 의미 → 종합 판단 순서로 근거를 대고, 동료 대비 분포 위치(p97)를 함께 보여준다.
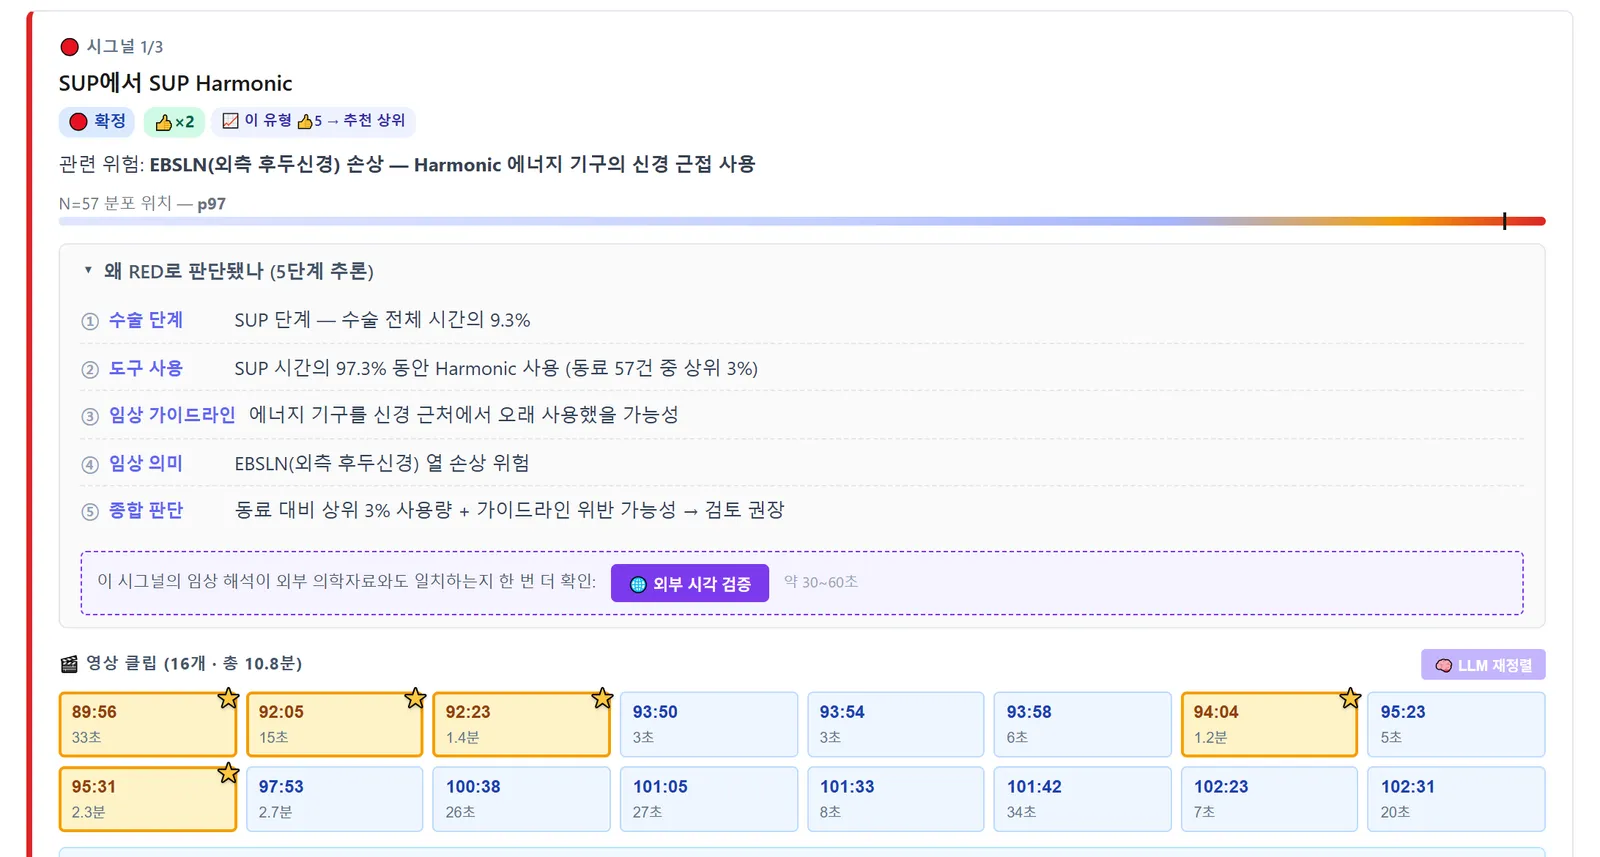
시그널 상세. 판단을 숨기지 않고 단계별로 해체해 보여주면, 의사는 어느 단계에서 동의하지 않는지 짚을 수 있다.
두 시간짜리 영상을 다 보게 하지 않으려고 클립도 골라준다. 룰이 별표로 선별한 위에 LLM 재정렬이 추가 후보를 얹는다.
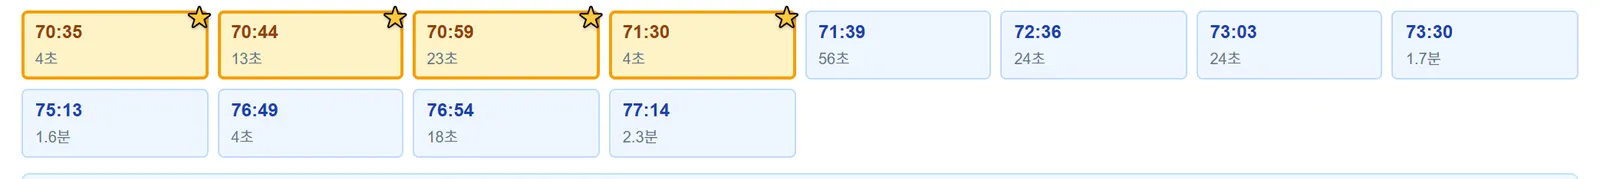
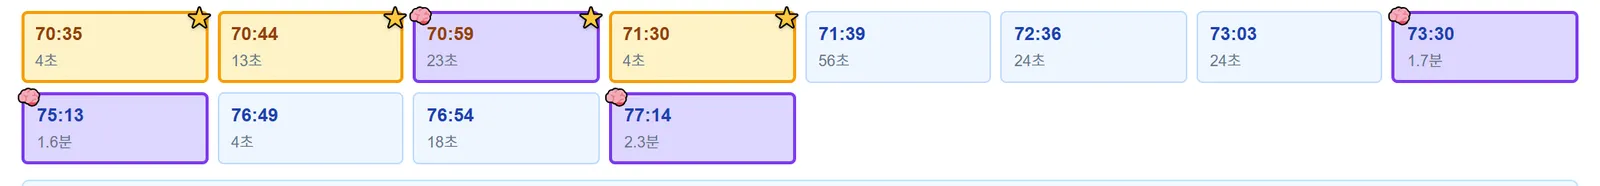
같은 클립 그리드의 전과 후. 별표가 룰 선별, 보라색이 LLM이 추가로 고른 클립이다.
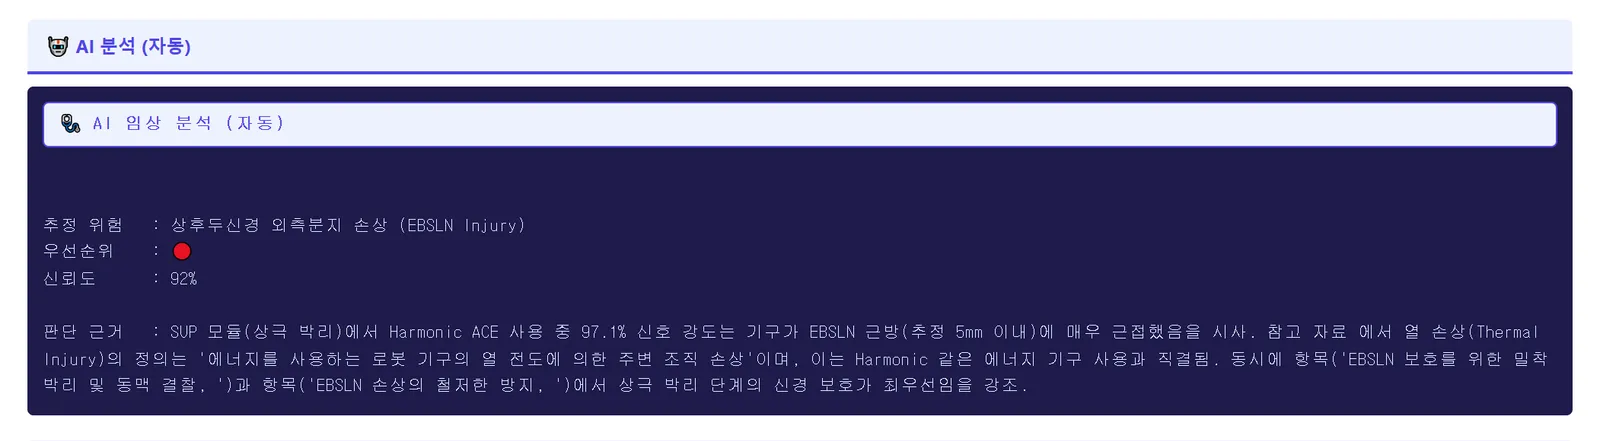
시그널마다 AI 임상 분석이 붙고, 그 해석이 외부 의학 자료와도 일치하는지 한 번 더 확인하는 검증 버튼을 뒀다.
어떻게 만들었나
문서가 코드보다 먼저. 페인 정의 → 결과물 → 데이터 구조 → 에이전트 구성 → 워크플로 순서로 기획 문서를 쌓고, 이 순서를 어기지 않는 것을 원칙으로 삼았다. 거꾸로 가면 “데이터가 있으니 뭐라도 보여주는” 엔진이 된다.
에이전트 10종 파이프라인. 입력 점검 → 수술 단계·기구 사용(병렬) → 임상 가이드라인 대조 → 임상 의미 해석 → 위험도 종합 → 결과 정리. 각 에이전트는 자기 룰만 갖고 판단하고, 룰은 코드가 아니라 YAML에 둔다 — 임계값을 바꿀 때 코드를 고치지 않는다.
주장마다 근거 마커. 기획 문서의 모든 주장에 근거 강도를 표시했다. 📌 문헌·회의록 직접 근거, ⚠ 자체 추론 가설, ❓ 적용 가능성 자체가 불확실. 면담에서 검증할 것과 이미 확정된 것이 문서 안에서 섞이지 않는다.
검증은 사이클로. 케이스 1건으로 파이프라인 통과를 시뮬레이션하고(사이클 1), 57건 분포로 시그널 판정을 재검증했다(사이클 2). 사이클이 끝나면 발견한 갭을 기록하고 그 시점의 워크스페이스를 통째로 동결한다 — 3주 동안 리포트를 12차례 냈고, v1부터 v4까지 네 번 동결했다.
걸렸던 것
숙련의에게 가치 있는 알림은 따로 있다. 처음 세운 페인 가설 5개는 대부분 일반 진료의 맥락이었다. 숙련의 관점으로 다시 쓰면서, “오진 두려움”은 “내 수술이 통상에서 이탈한 순간의 사후 검토”로 바뀌었고, 변형이 안 되는 가설은 버리는 대신 ❓를 달아 면담에서 적용 여부부터 묻기로 했다. 페르소나가 바뀌면 페인 문장 자체를 다시 써야 한다는 걸 이 프로젝트에서 배웠다.
데이터가 판단을 감당하지 못하는 구간이 있다. 영상의 70% 이상이 구간 미분류로 남은 케이스가 3건 있었고, 직접 임상 근거 항목 5개는 아직 비어 있어 분석이 간접 추정 기반이다. 이걸 조용히 빼는 대신 대시보드 첫 화면의 “데이터 점검”에 그대로 올렸다. 의사에게 보여주기 전에 시스템이 먼저 정직해야, 면담에서 신뢰를 얻는다고 봤다.
어디까지 왔나
파이프라인은 두 사이클을 통과했고, v4에서 자동화로 넘어가는 중이다 — 페이지를 열면 분석이 자동으로 돌아 캐시로 즉시 표시되고, 판정이 충돌하면 LLM judge가 자동 개입한다.
다만 이 시스템의 판단 기준은 아직 전부 가설이다. 화면의 “임계 가설 · 미검증” 배지가 그 상태를 그대로 말한다. 전문가 면담으로 가설을 확정하거나 폐기하는 관문이 남아 있다.
남은 것
전문가 면담이 다음 관문이다. ❓로 남긴 가설들은 적용 가능성부터 물어야 한다. 자동화 쪽은 멀티 세션 동시 실행과 일괄 분석이 남았고, 피드백(👍/👎)이 다음 추천 순서를 보정하는 랭킹은 더 다듬는 중이다.